如何在 Chrome 中让扫描版 PDF 可搜索
扫描版 PDF 只是页面的图片,所以无法搜索,也无法选中其中的文字。在 Eofent Capture 的 PDF 编辑器中打开它,选择“使其可搜索 (OCR)”。它会在你的电脑上识别页面,并在每个词上叠加一层不可见的文字层。
7 个步骤 · CHROME 和 EDGE
1打开 PDF
打开“PDF 及更多”标签,点按“打开 PDF”,然后选择文件。
2选择“使其可搜索 (OCR)”
你可以在左侧的“快捷工具”中找到它,也可以在“所有工具”里找到。每一页都会显示它是扫描页,还是已经有文字。
3选择文档的语言
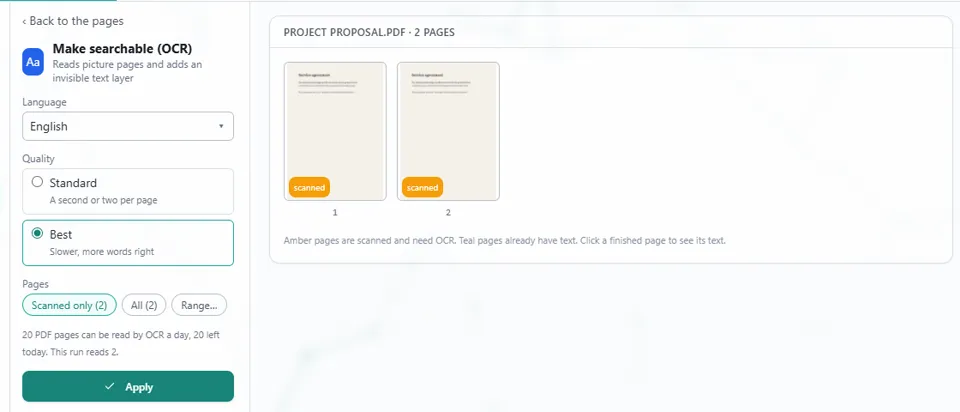
选择文档所用的语言,这样识别出的词才会准确。
4选择质量
“标准”每页需要一两秒。“最佳”更慢,但识别正确的词更多。
5选择页面
“仅扫描页”会跳过已经有文字的页面。你也可以选择“全部”或“范围”。
小提示
免费账户每天可识别 50 页,未登录 20 页。
6点按“应用”
文字层会作为一个可以撤销的步骤添加进去。
7打开“保存”,然后选择“导出”
点按“导出 PDF”,可搜索的文件会保存到你的“下载”文件夹。
安装 Eofent Capture
Eofent Capture 可免费开始使用;免费版有每日额度。 查看方案 →